JPA Pattern Analyzer
코드 분석 기반 JPA 패턴 학습 및 성능 비교 도구
- 기간
- 2025.12.19 ~ 2025.12.19
- 기술
- JavaScript, WASM, Tree-sitter
- 링크
- 사이트 ↗
개발 배경: 복잡한 JPA 쿼리, 어떻게 관리할까?
실무에서 JPA를 도입하면서 가장 많이 부딪힌 질문은 "이 쿼리는 어떤 방식으로 짜는 게 맞을까?" 였다.
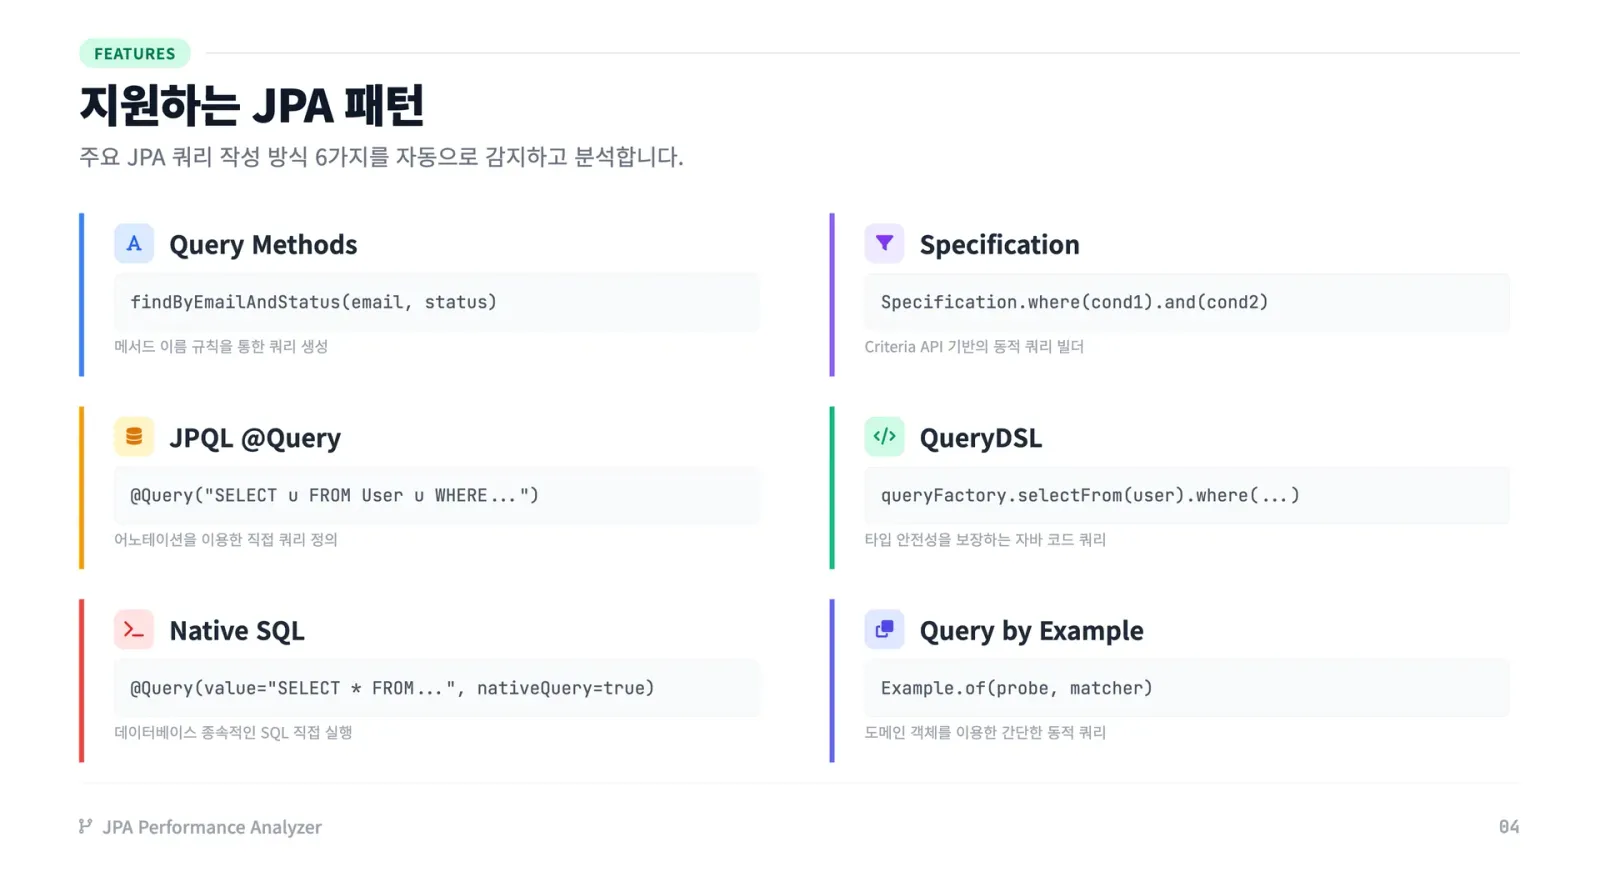
Query Method, @Query(JPQL), Specification, QueryDSL 등 선택지는 많았지만, 팀원마다 선호하는 방식이 달랐고 각 방식의 장단점을 명확한 수치로 비교하기도 어려웠다.
특히 "QueryDSL이 컴파일 타임에 안전하니까 무조건 좋다" 라거나 "Specification은 가독성이 떨어지니 쓰지 말자" 같은 주관적인 의견이 오갈 때마다, 코드 레벨에서 객관적으로 비교해 줄 기준이 절실했다.
문제 분석: '감'에 의존하는 성능 튜닝
흔히 쿼리 성능을 이야기할 때는 실제 DB 실행 시간(Execution Time)에만 집중한다. 하지만 JPA 같은 ORM 환경에서는 애플리케이션 로딩 시점의 파싱 비용이나 동적 쿼리 빌딩 오버헤드 같은 '숨은 비용'도 무시할 수 없다.
- Query Method — 메서드 이름이 길어질수록 파싱 비용이 늘어난다.
- JPQL — 문자열 기반이라 런타임 에러 위험과 리팩터링 비용이 있다.
- QueryDSL — Q클래스 생성과 빌더 패턴 사용으로 초기 컴파일 오버헤드가 있다.
이런 코드 복잡도(Code Complexity) 와 이론적 오버헤드를 개발 단계에서 미리 시뮬레이션해 볼 수 있다면, 더 나은 기술적 의사결정을 내릴 수 있지 않을까?
해결 과정: AST 분석을 통한 정량화
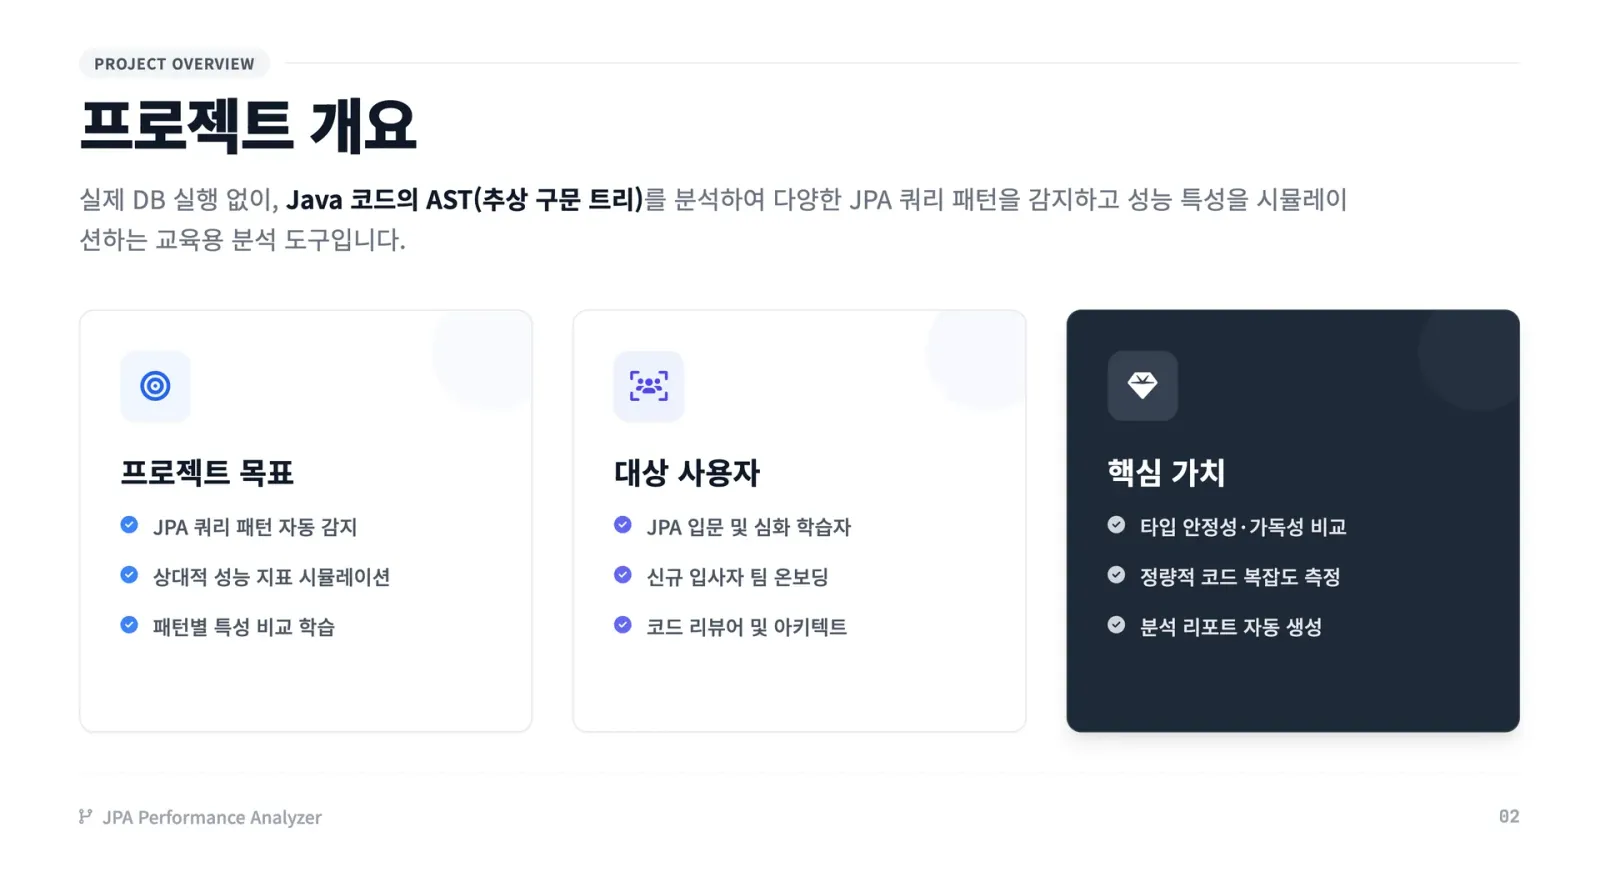
이 문제를 풀기 위해 Java 코드를 직접 파싱해 분석하는 도구를 만들기로 했다. 핵심은 Tree-sitter 라이브러리로 웹 브라우저에서 실시간으로 Java 코드의 AST(Abstract Syntax Tree, 추상 구문 트리) 를 만드는 것이었다.
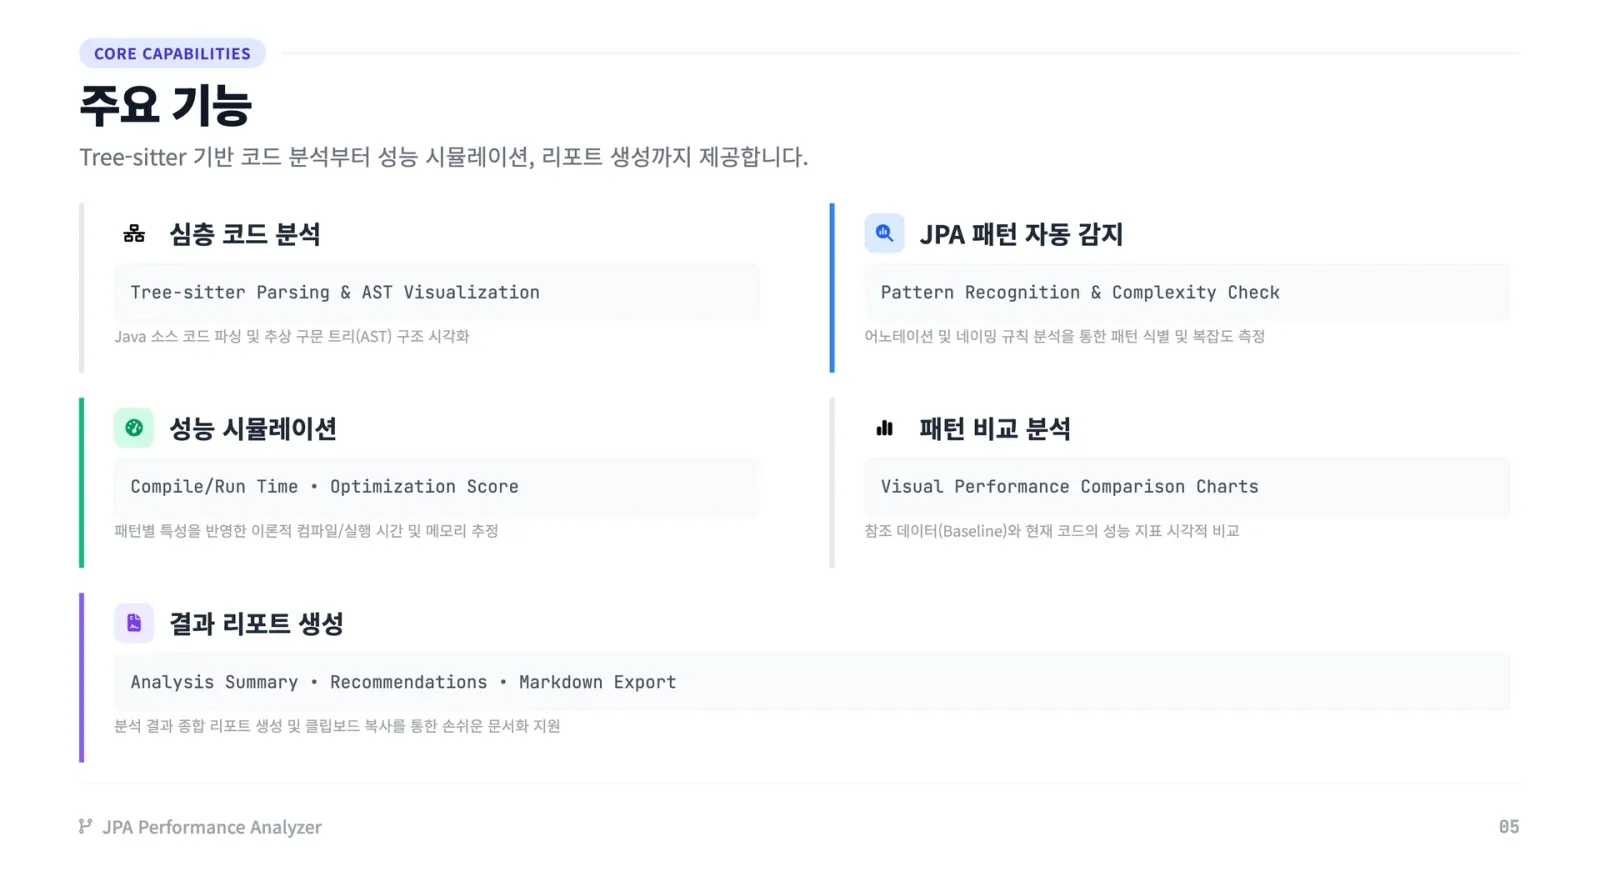
주요 분석 로직
1. 패턴 감지
AST를 순회하며 Query Method, @Query, Specification 등 JPA 사용 패턴을 자동으로 식별하고 분류한다.
2. 복잡도 산출
코드 라인 수, 조건문의 깊이, AST 노드 개수 등을 종합해 정량적인 복잡도 점수를 계산한다.
3. 성능 시뮬레이션
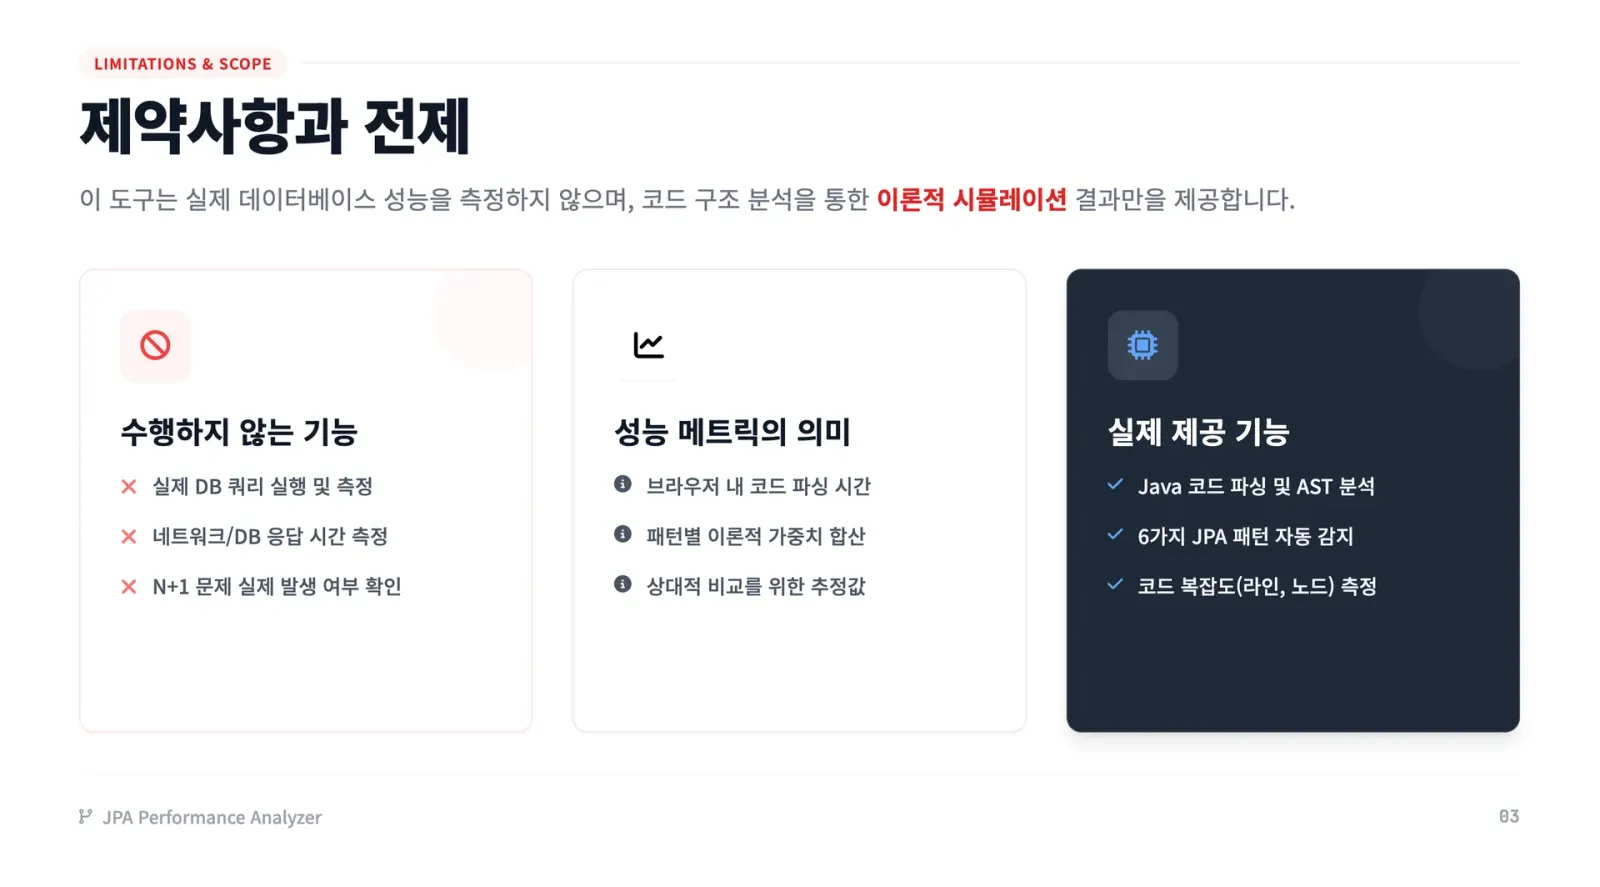
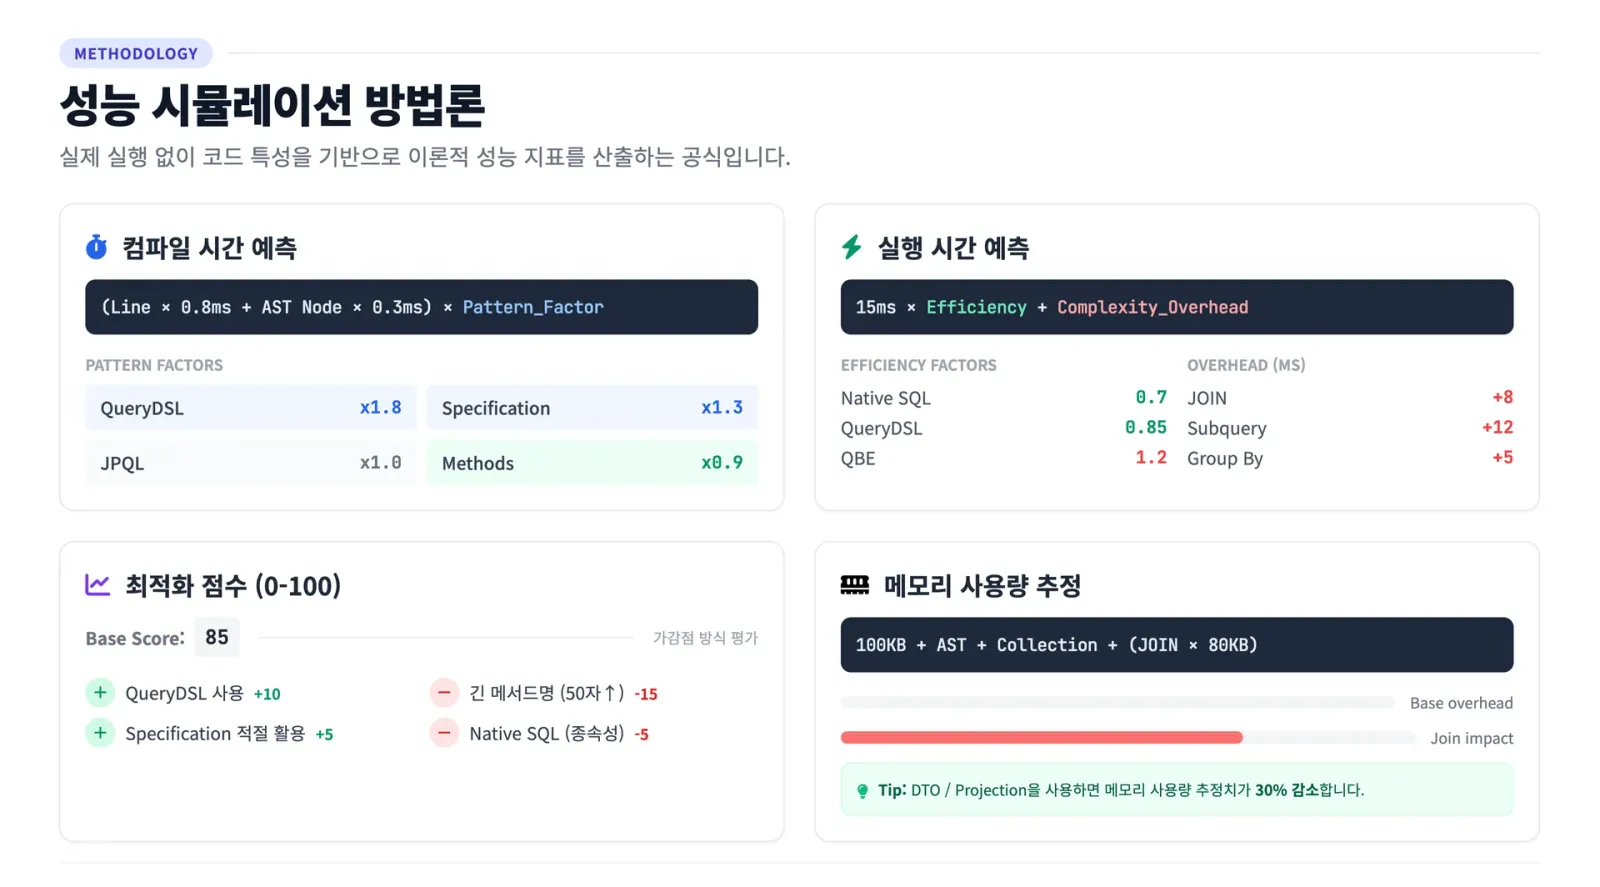
실제 DB 연결 없이도 패턴별 오버헤드 계수(Coefficient)를 적용해 이론적인 컴파일·실행 효율을 예측한다.
// 시뮬레이션 로직 예시
const predictedCompileTime = (lineCount * 0.8 + astNodeCount * 0.3) * patternCoefficient;
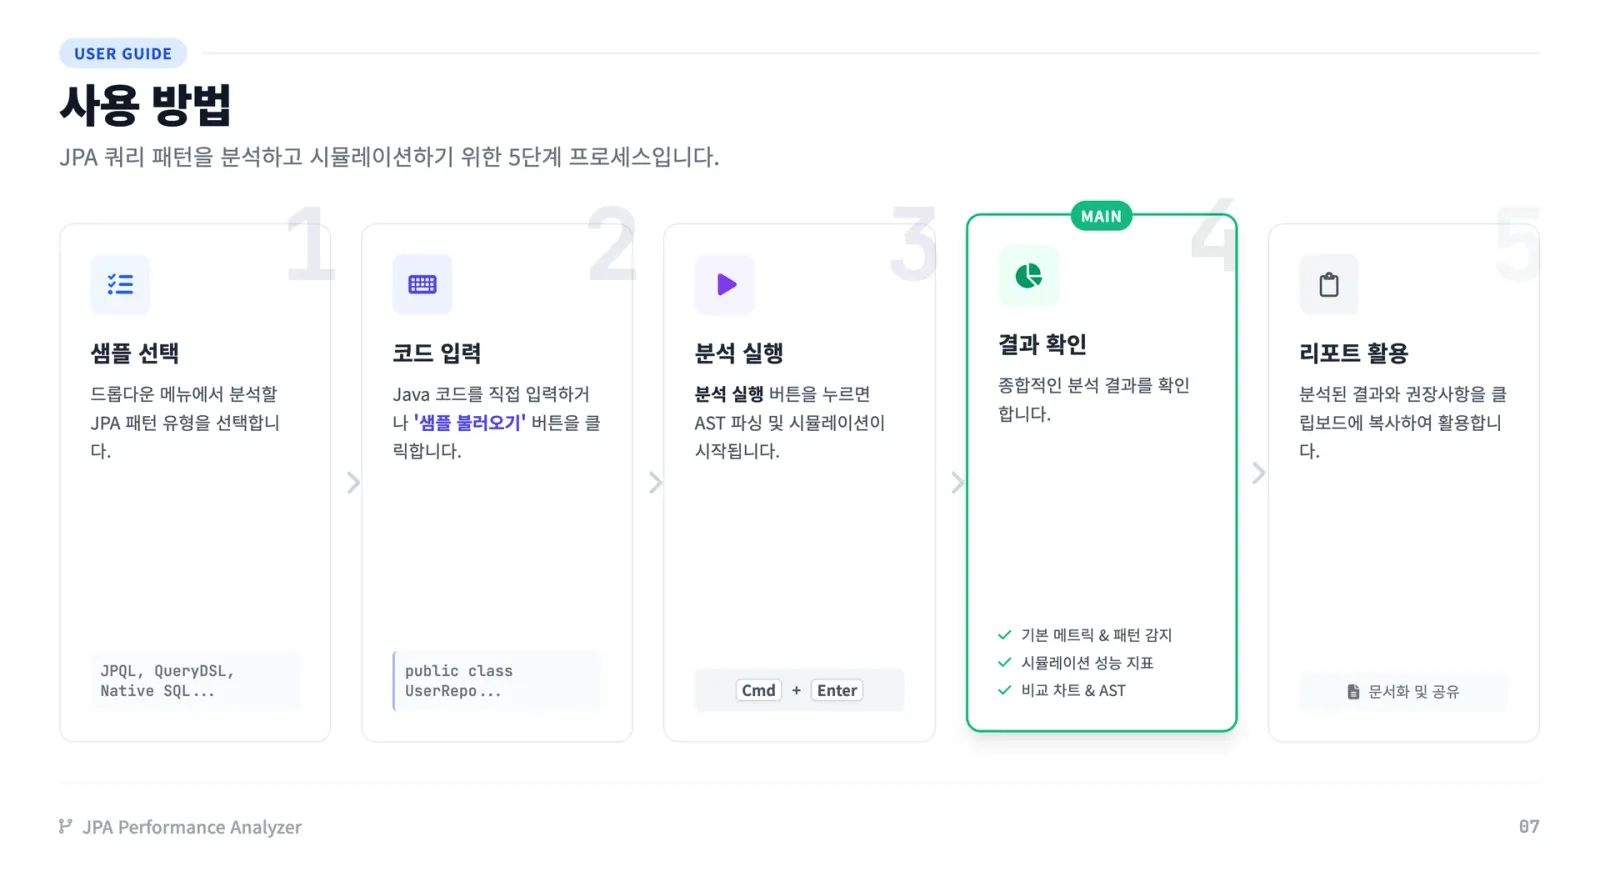
덕분에 코드를 붙여 넣기만 하면 "이 코드는 컴파일 비용이 높지만 런타임 안정성이 뛰어납니다" 같은 구체적인 피드백을 받을 수 있다.
결과물 및 배포
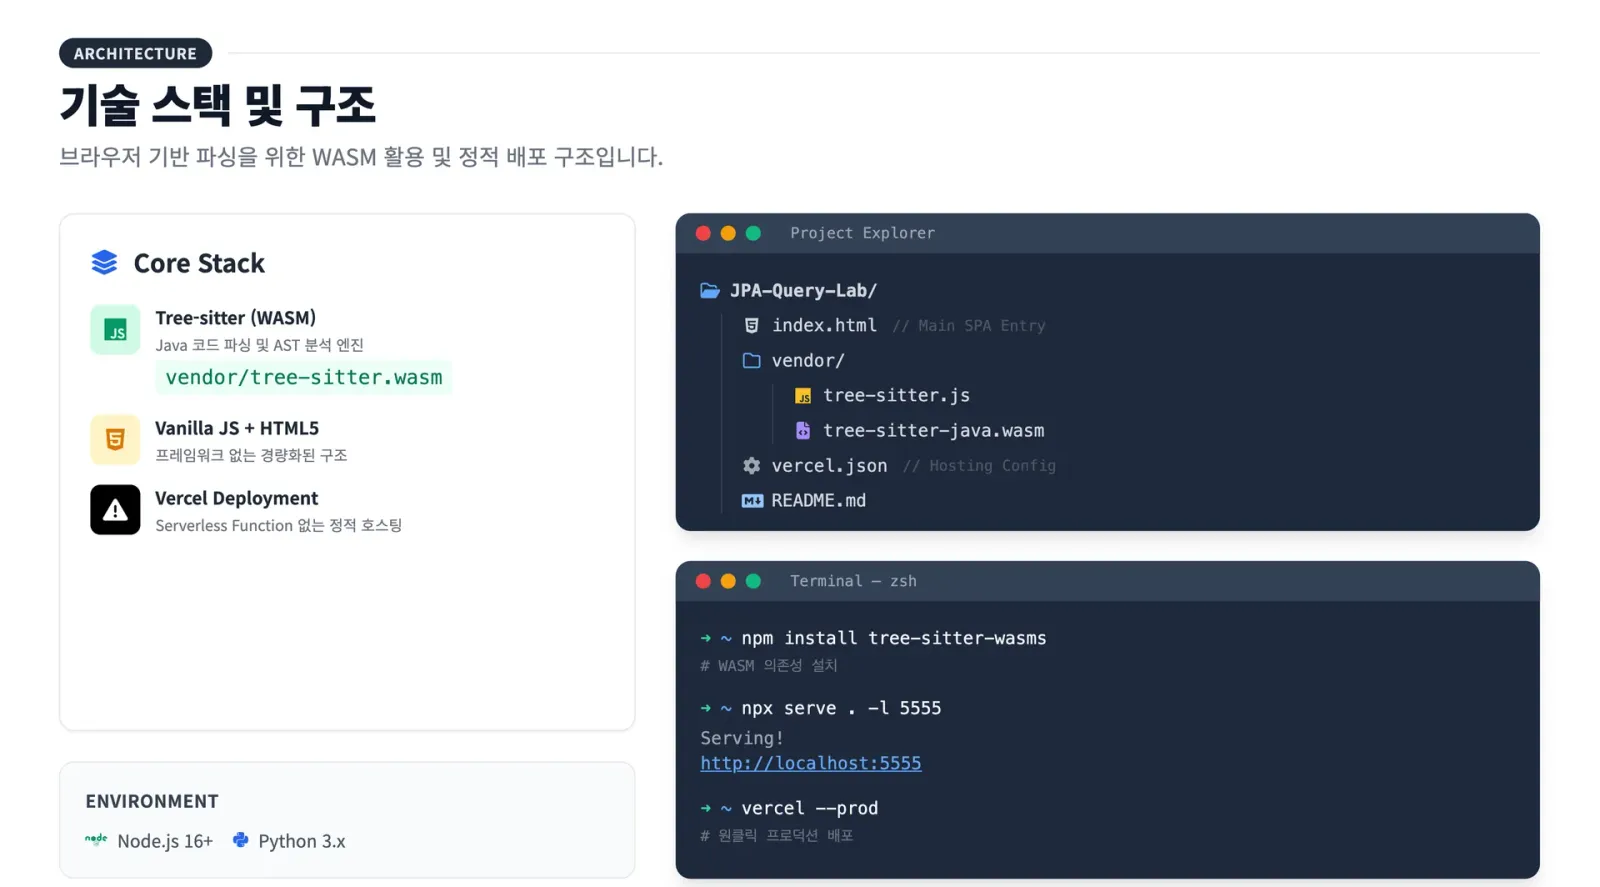
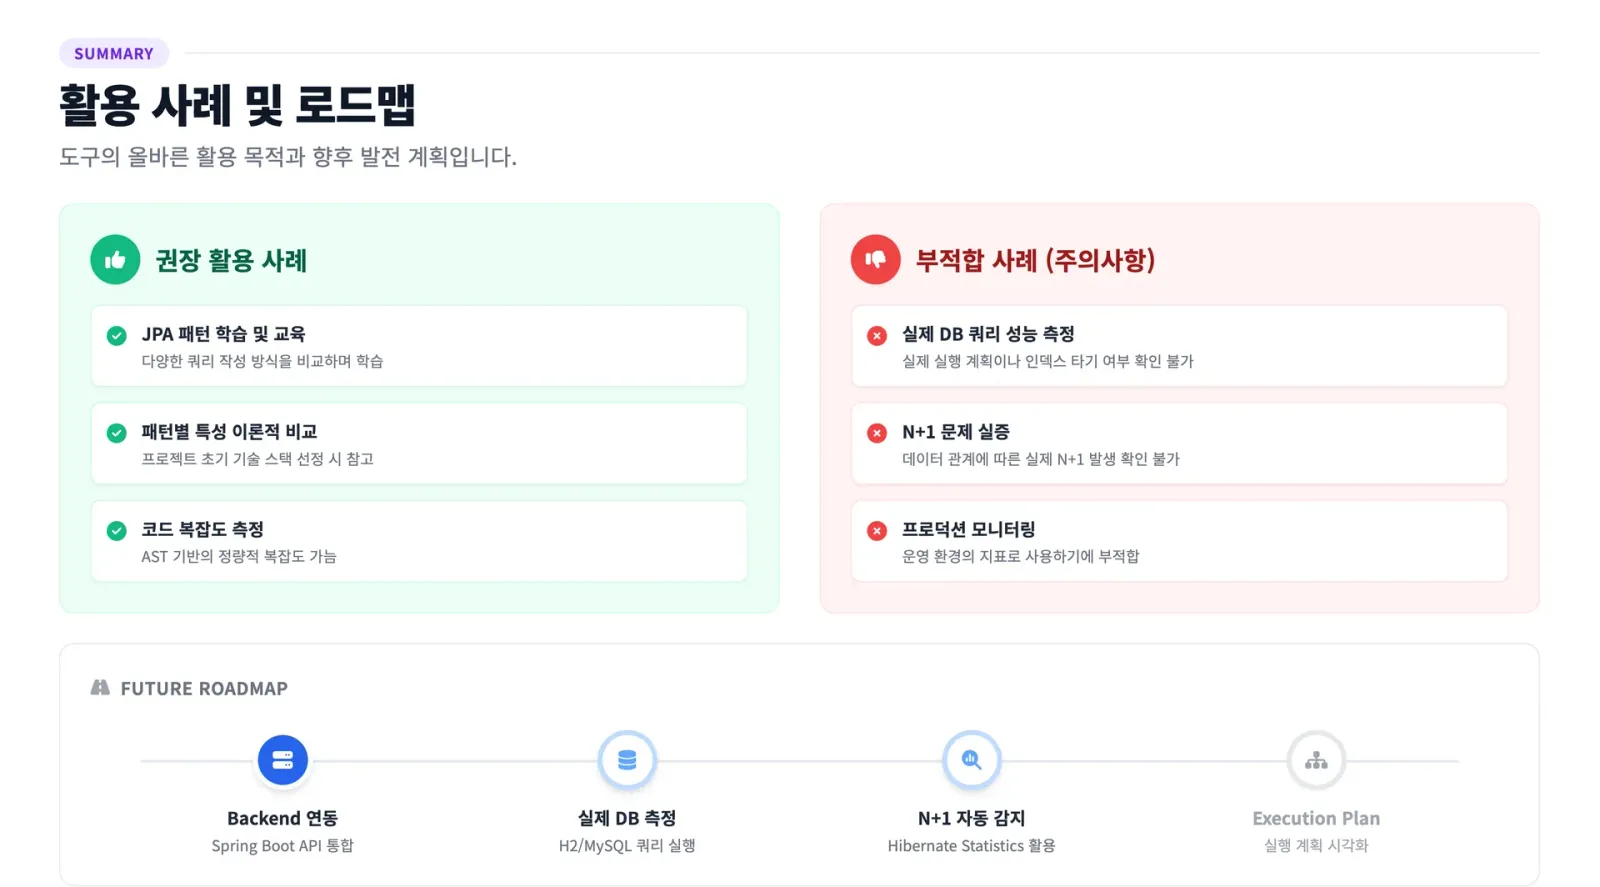
완성된 JPA Pattern Analyzer는 별도 백엔드 서버 없이 브라우저(WASM) 환경에서만 동작하는 분석 도구가 되었다. JPA를 처음 배우는 사람에게는 패턴별 차이를 시각적으로 보여 주는 학습 도구로, 실무자에게는 코드 리뷰 때 객관적인 복잡도 지표를 주는 보조 도구로 쓰일 수 있을 것 같다.
- Tech Stack — HTML, CSS, Vanilla JavaScript, Tree-sitter (WASM)
만들며 한 생각