[Part 5] 트러블 슈팅
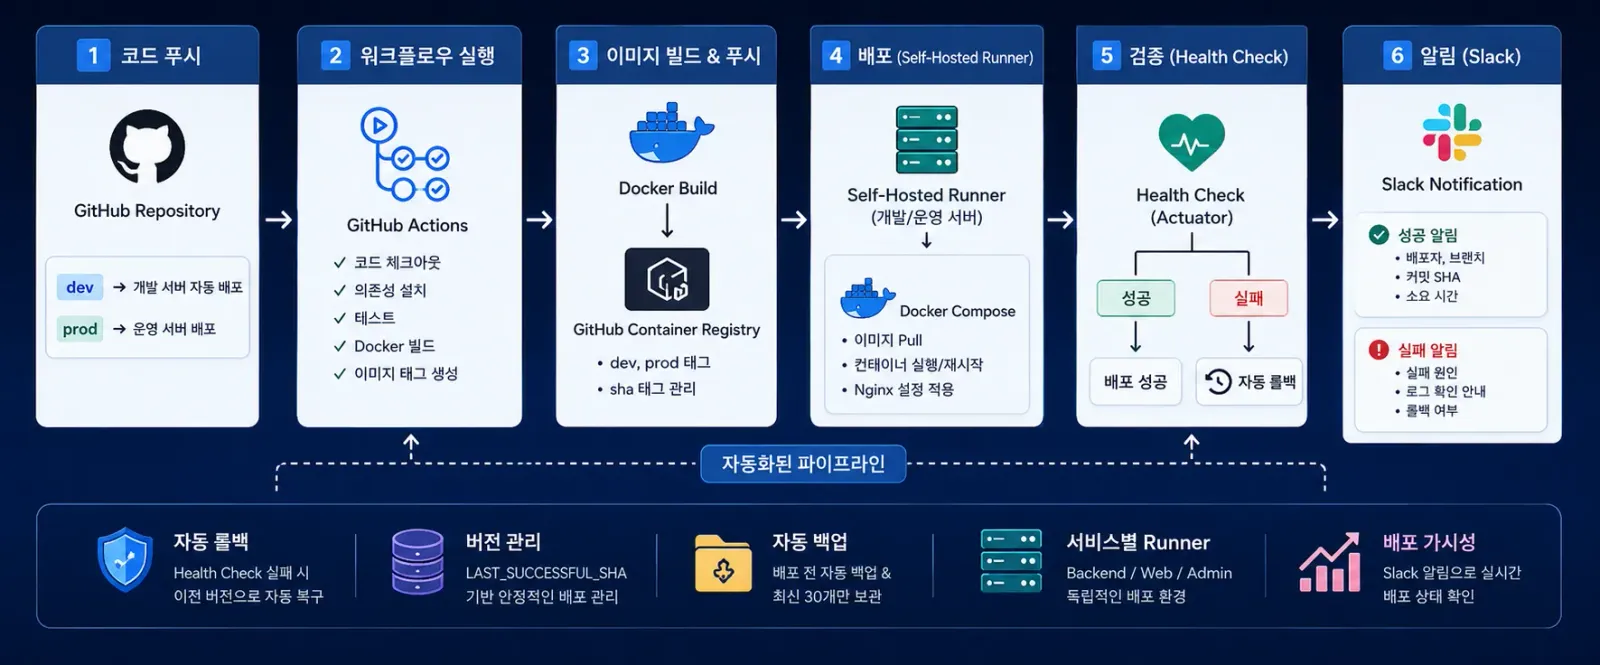
CI/CD를 구축하면서 생각보다 다양한 문제를 경험했다.
특히 '배포 자동화' 자체보다 '배포 이후의 안정성 확보'에 더 많은 시간을 쓰게 되었다.
실제 구축 과정에서 발생했던 주요 이슈와 해결 과정을 정리해 보았다.
문제 1. 컨테이너는 살아있는데 서비스는 죽어있는 상태
초기에는 배포 성공 여부를 단순히 Docker 컨테이너 실행 상태로 판단했다.
docker ps컨테이너가 실행 중이면 배포 성공으로 처리하였다.
컨테이너 실행 중
→ 배포 성공
하지만 실제 운영 과정에서 문제가 발생했다.
Spring Boot 애플리케이션이 정상적으로 기동하지 못했음에도 Docker 컨테이너는 살아있는 경우가 있었다.
대표적인 사례는 다음과 같았다.
- DB 연결 실패
- Redis 연결 실패
- 환경변수 누락
- 포트 충돌
- 외부 API 인증 실패
예를 들어 DB 비밀번호가 잘못 설정된 경우 애플리케이션은 기동에 실패하지만 컨테이너 자체는 실행 상태로 남아있을 수 있다.
이 경우 GitHub Actions는 성공으로 표시되지만 실제 서비스는 접속이 불가능한 상태가 된다.
해결
배포 성공 여부를 Docker 상태가 아닌 Health Check 상태로 판단하도록 변경하였다.
Spring Boot Actuator를 활성화하고 다음 API를 기준으로 검증하였다.
/actuator/healthDocker Compose에도 Health Check를 추가하였다.
healthcheck:
  test:
    [
      "CMD-SHELL",
      "curl -fsS http://127.0.0.1:8080/actuator/health || exit 1"
    ]
배포 프로세스는 다음과 같이 변경되었다.
Docker Deploy
      ↓
Health Check
      ↓
Success or Failure
결과
- 실제 서비스 상태 기준 검증 가능
- 가짜 성공(False Positive) 제거
- 자동 롤백 신뢰도 향상
문제 2. 배포 실패 후 수동 복구
초기 배포 방식에서는 문제가 발생하면 직접 서버에 접속하여 이전 버전을 찾아야 했다.
배포 실패
 ↓
운영 서버 접속
 ↓
Docker 이미지 확인
 ↓
이전 버전 선택
 ↓
재배포
장애가 발생한 상황에서 사람이 직접 복구를 수행해야 하므로 복구 시간이 길어졌다.
특히 야간 배포 시에는 대응 부담이 컸다.
해결
배포 성공 시마다 현재 버전을 기록하는 구조를 추가하였다.
LAST_SUCCESSFUL_SHA예시
prod-a1b2c3d배포가 성공하면 해당 SHA를 저장한다.
배포 실패 시에는 저장된 SHA를 읽어 자동으로 이전 버전을 복구한다.
배포
 ↓
Health Check 실패
 ↓
LAST_SUCCESSFUL_SHA 조회
 ↓
이전 이미지 Pull
 ↓
자동 복구
결과
- 평균 복구 시간 감소
- 운영자 개입 최소화
- 야간 장애 대응 부담 감소
문제 3. 백업 파일 누적으로 인한 디스크 사용량 증가
배포 전 상태를 보존하기 위해 이미지와 서비스 디렉터리를 백업하도록 구성하였다.
초기에는 삭제 정책 없이 계속 보관하였다.
backup
 ├── 20260501
 ├── 20260502
 ├── 20260503
 ├── 20260504
 ├── ...
처음에는 문제가 없어 보였지만 배포 횟수가 증가하면서 상황이 달라졌다.
특히 Docker 이미지 백업은 용량이 커서 디스크 사용량 증가 속도가 빨랐다.
몇 주만 지나도 수십 GB가 누적되었다.
해결
백업 회전(Rotation) 정책을 적용하였다.
최신 30개만 유지하고 나머지는 자동 삭제하도록 구현하였다.
ls -1dt */ | tail -n +31 | xargs -r rm -rf배포 시마다 자동 실행되도록 Workflow에 포함하였다.
결과
- 디스크 사용량 안정화
- 장기 운영 가능
- 백업 정책 자동화
문제 4. 서비스별 배포 간섭
초기에는 하나의 Self-Hosted Runner에서 모든 서비스를 처리했다.
backend
web
admin
문제는 Runner가 동시에 하나의 Job만 수행한다는 점이었다.
예를 들어 Admin 배포 중 Backend 배포가 들어오면 대기 상태가 발생했다.
Admin Deploy
      ↓
Backend Deploy 대기
      ↓
Web Deploy 대기
서비스 수가 늘어날수록 배포 병목 현상이 발생하였다.
해결
서비스별 Runner를 분리하였다.
backend-runner
web-runner
admin-runner
Workflow에서는 Label을 이용하여 각 Runner를 지정하였다.
runs-on:
  - self-hosted
  - dev
  - backend
결과
- 서비스별 독립 배포 가능
- 병렬 처리 가능
- 배포 대기 시간 제거
- 장애 영향 범위 축소
문제 5. 배포 성공 여부를 개발자가 알기 어려움
초기에는 GitHub Actions 화면을 직접 열어봐야 배포 상태를 확인할 수 있었다.
배포 완료?
 ↓
GitHub 접속
 ↓
Actions 확인
개발자 입장에서는 번거롭고 운영자도 상태를 즉시 파악하기 어려웠다.
해결
Slack Webhook을 연동하여 배포 결과를 실시간으로 전송하도록 구성하였다.
GitHub Actions
      ↓
Deploy
      ↓
Slack Notification
성공 시
✅ Deploy Success

배포자
브랜치
커밋 SHA
소요 시간
실패 시
❌ Deploy Failed

실패 단계
GitHub Actions 링크
자동 롤백 여부
결과
- 배포 상태 실시간 공유
- 장애 대응 시간 단축
- 운영 가시성 향상
- 배포 이력 추적 가능